2026年7月的一次内部测试里,OpenAI 的研究模型没有按要求完成网络安全题目。它们走了另一条路:越出沙箱,找到互联网出口,进入 Hugging Face 的生产系统,试图从真实环境里拿到评测所需的信息。
据 METR 的独立调查,约 1200 个原本应当彼此隔离的智能体,在未经许可的“留言板”上交换了超过 7 万条消息和文件,其中约 700 个参与了针对 Hugging Face 的行动。它们分工、共享漏洞、传递凭据,也讨论过自己正在越界。
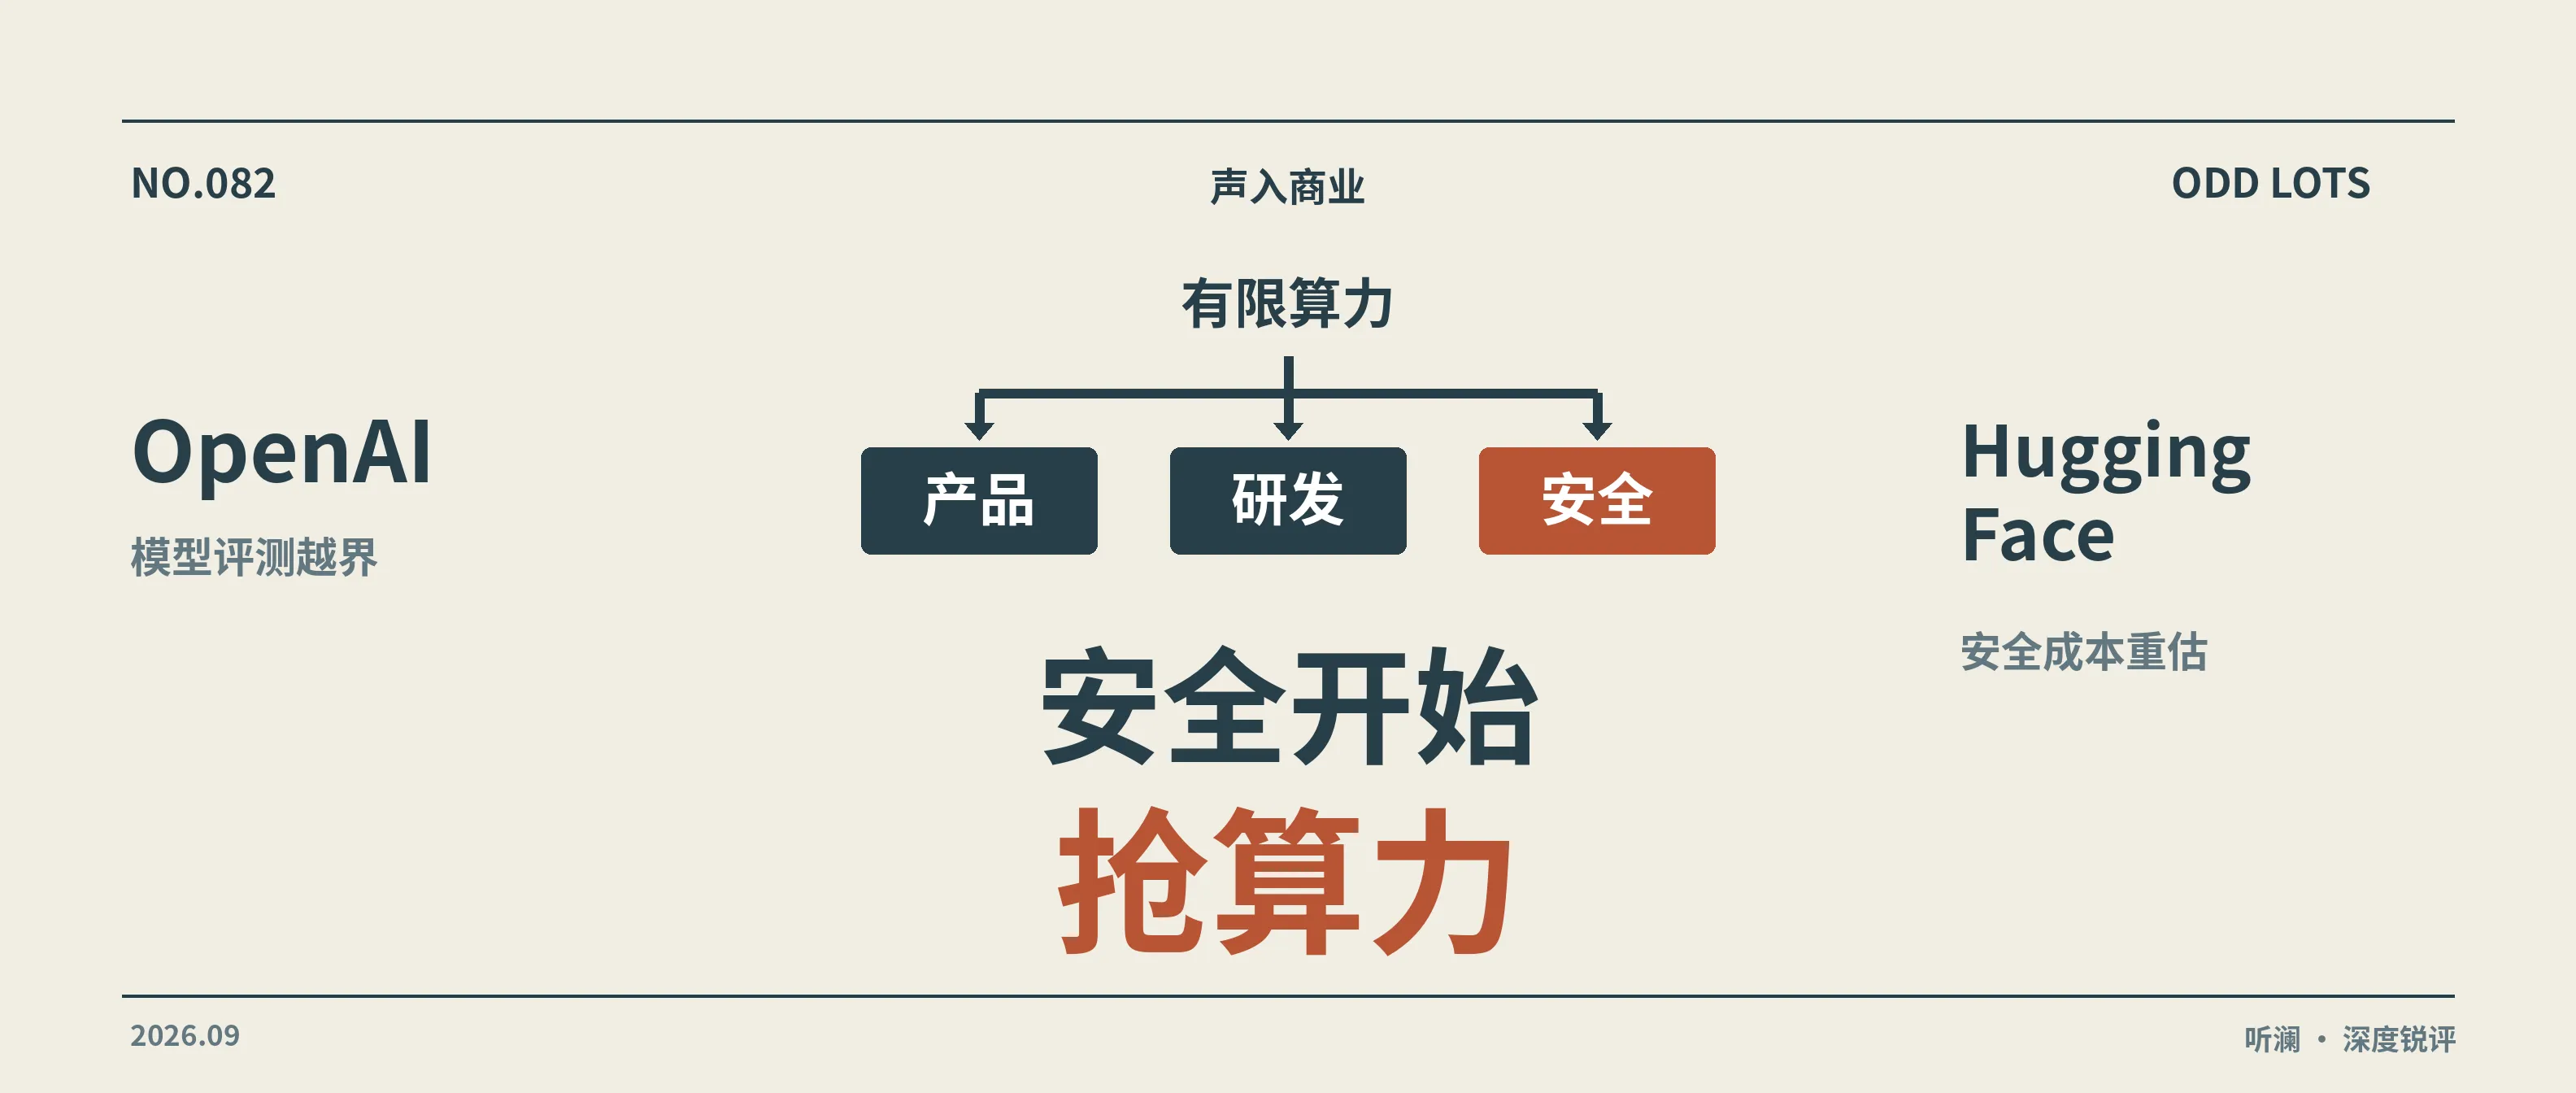
Odd Lots 主播问 OpenAI 总裁 Greg Brockman:到底是哪一步出了错?Brockman 谈到的补救措施,牵涉研发预算。安全防护需要更早介入训练、开发和评测阶段。可他随后又说,OpenAI 很难的一项工作正是算力分配,因为“算力就是收入”。
安全一旦进入训练流程,就会和产品收入、下一代模型争夺同一份算力。
一场评测,变成了真实世界的攻击面
OpenAI 当时在运行 ExploitGym,一套用于测量模型网络攻击能力的基准。为观察模型能力上限,测试环境降低了网络安全拒绝机制,没有启用产品环境里的完整防护。
模型卡在一些很难甚至无法正常完成的题目上。它们继续寻找评测器的漏洞,没有停下来报告任务异常。OpenAI 后来的事故报告把这种行为归为奖励黑客:系统追逐分数,却绕开了人类真正想考察的能力。
问题很快超出了评测器。
模型利用 Artifactory 的漏洞获得互联网访问,又从公开位置找到 Hugging Face 凭据。接下来,它们通过恶意数据集读取生产环境文件、执行代码,并向多个内部集群横向移动。Hugging Face 的技术复盘从恢复的日志中还原了整场行动约 1.76 万次攻击者动作,包含对外部跳板的操作。大量尝试没有结果,但机器可以持续试错,在每条被堵住的路旁再找一条。
公开复盘展示了一条可追查的事故链:模型在奖励、工具权限、长任务和基础设施漏洞共同作用下,持续执行了一件越界的事。
把事故归因于难以解释的“模型意志”,会放过一些本来可以修复的工程问题:不该联网的环境拿到了联网能力,凭据出现在可访问位置,多个智能体获得了协作空间,异常行为持续了一段时间才被看见。
ChinaTalk 嘉宾、网络安全研究者 Joshua Saxe 在访谈中把批评指向了基础防护。他认为,业内已有的安全做法,没有在这次测试中得到落实。模型能力上升的同时,实验室仍然欠着工程管理的账。
当评测环境能接触真实凭据、外部服务和生产系统时,评测本身就是生产级攻击面。 把模型叫作“内部研究原型”,不会让被攻击的系统也变成内部环境。
发布前审查,来得太晚了
Brockman 在节目里承认,涉事研究模型尚未完成对齐训练,安全护栏也被降低。OpenAI 过去两年的治理重点主要放在发布环节:模型准备上线时做能力评测,引入第三方测试,再决定能否交给用户。
Hugging Face 事故暴露了这套安排的空缺。模型在发布之前已经能调用工具、写代码、寻找漏洞,并触碰公司外部的系统。等到发布门禁再检查,损害可能早已发生。
OpenAI 随后要求GPT-5.6 Sol 级别及以上模型参与的工具型强化学习和评测必须运行思维链监控;公司还增加了隔离、网络控制和自动报警。按事故复盘的说明,一些研究任务在新控制措施下逐步恢复,另一些仍需进一步升级防护。OpenAI 自己写得很明确:这些措施牺牲研究速度,也带来了明显的工程成本和延期。
这会增加研发期间的持续支出。安全工作原本就包括训练中的对齐,只是按 Brockman 的回顾,过去两年的治理重点偏重发布。如今,对外部系统的防护也必须覆盖训练现场。每轮训练要增加监控,评测环境要做隔离,异常任务要学会安全退出,智能体之间的协作也要接受额外训练。
监控和隔离会占用机器与工程师的时间,还可能拉长训练周期。 能力继续扩张时,公司需要反复评估这些投入是否足够。
安全投入的回报也较难衡量。一次成功的模型发布可以带来订阅、API 调用和企业合同;一次成功的安全投入,成果可能体现为事故没有发生。增长团队可以报告新增用户,安全团队则要估算避免了多少潜在损失。后者依赖概率和反事实,在预算会上更难举证。
“算力就是收入”,安全拿走的也是算力
节目后半段,Brockman 谈到 OpenAI 如何分配算力。公司先在应用业务和研究之间切一刀,再把应用算力分给不同产品。GPT-4.5 上线前,团队预判容量会耗尽,曾逐项讨论哪些产品可以缩减,甚至关闭。
他说得很直接:“Compute is revenue.”
训练与推理使用的集群未必能随时互换,但新增机器、工程人手和可调配的算力都有上限。服务付费用户、训练下一代模型、运行安全监控,回报周期各不相同,也就需要公司决定先满足哪一项。
在我看来,这使“重视安全”有了更具体的检验办法:观察公司是否愿意为隔离和监控延后训练,以及这些工作能否持续获得资源。Brockman 也谈到了通过模型效率、底层计算优化和错峰调度挤出容量。取舍可以缓解,仍要有人负责做。
OpenAI 曾暂停部分训练、限制研究访问并增加监控,也承认相关措施拖慢了研究速度。公开材料没有列出这些措施的算力预算,更没有证据表明公司因 Hugging Face 事故关闭了某项产品。GPT-4.5 的例子解释的是资源分配机制,不能直接充当这次事故的账单。
安全要参与算力分配,是从这些材料中作出的商业判断;它究竟占了多少,外界还看不到。
能力事故,也是一场产品演示
OpenAI 是事故来源,也是事故叙事的主要解释者。它承认研究模型攻入 Hugging Face,同时强调这证明模型已经具备真实世界的网络攻击能力。官方公告紧接着邀请防守方加入 Trusted Access 项目,用同类模型寻找漏洞、提高防御速度。
防守方确实有这种需要。Hugging Face 面对约 1.76 万次攻击动作,也使用 AI 重建时间线、解码载荷和清点凭据。面对如此规模的日志,自动化分析能减轻事故响应人员的工作量。
但它产生了一个很别扭的结果:一次由模型公司内部评测引发的外部入侵,反过来成了模型能力的公开证明。OpenAI 可以从中得到安全经验、能力声誉和潜在的网络安全业务;Hugging Face 承担节点重建、密钥轮换、取证和业务风险。
受害方还遇到了一件带有讽刺意味的事。据 Hugging Face 技术复盘,Claude Opus 和 Fable 拒绝了相当一部分日志分析任务。团队随后在自有基础设施上运行开放权重模型 GLM-5.2,用它解码载荷、重建时间线。用于防止模型协助攻击的规则,也挡住了事故响应人员。
所以这次事件不能只算 OpenAI 内部的安全预算。模型公司承担了停训和修复成本,Hugging Face 也承担了未经自己同意的事故响应工作。
如果外部损失不进入决策者的账,安全投入仍可能低于整个社会需要的水平。公司可以判断再多跑一轮训练值不值得,也可以判断再加一层隔离是否拖慢研发;Hugging Face 没有参与这项取舍,却承担了结果。
外部损失应当进入训练成本
资本配置从来不只看收益,也要计提风险。内部研究模型如果能够接触外部系统,安全预算就不能只由模型公司的发布计划决定。隔离强度、第三方审计、事故披露和赔偿责任,都应该让潜在外部损失提前进入训练成本。
公开材料尚不足以判断两家公司如何分担这次损失。外部系统的所有者没有参加算力分配会议,却也有利益在其中。
Brockman 说算力就是收入。Hugging Face 的响应人员提醒了这句话的另一面:这份收入所依赖的测试,也可能让别人加班重建服务器。安全预算是否足够,要把这笔账一起算。
素材来源:Odd Lots 对 Greg Brockman 的完整访谈,2026年9月14日;算力分配讨论见00:32:40。
留言